商业问题定义
先把“客户流失”变成一个清楚的业务判断问题,理解商家为什么需要在客户真正离开前做识别。
系统建模 · 机器学习商业分析
面向咖啡馆等小型业态的客户流失预警系统项目,用多因子特征工程、随机森林和 Flask 可视化,把“谁可能流失”做成可执行的运营判断。
项目从真实经营问题出发,把客户消费行为、互动记录和价值贡献组织成一套可预测、可解释、也可展示的机器学习系统,适合对数据科学、商业分析和 AI 落地感兴趣的学生。
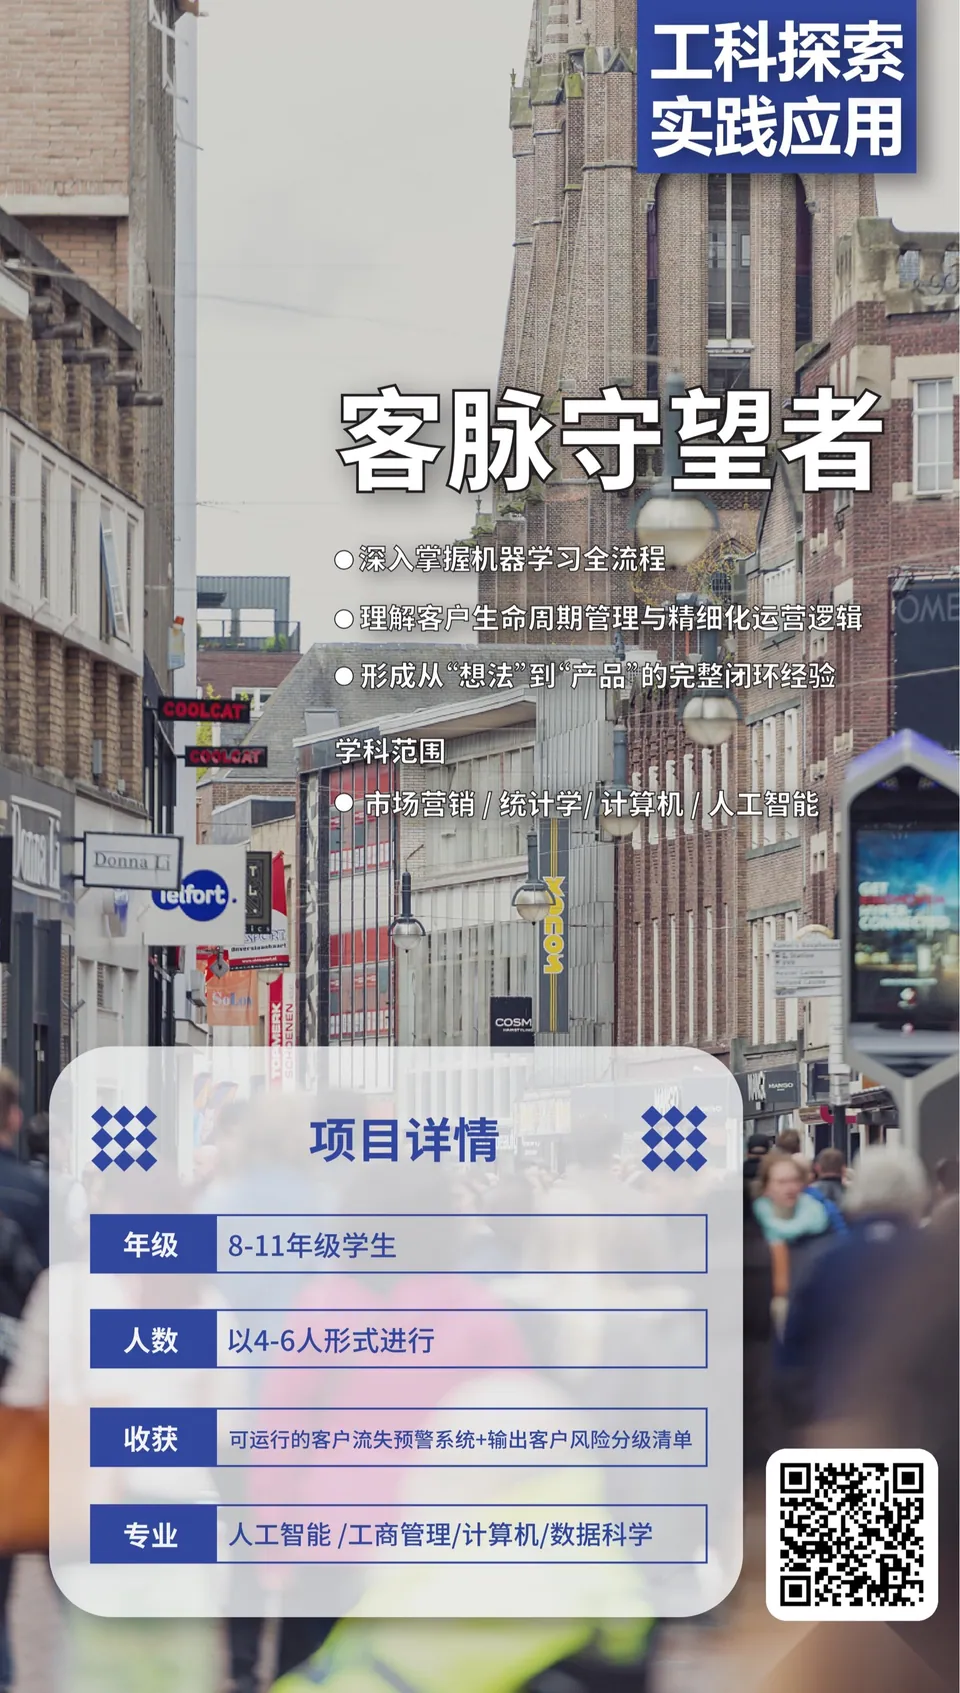
从真实商业问题拆解、客户数据清洗、RFM 与多因子特征工程,到随机森林建模、Flask 后台和 ECharts 看板展示,完整做出一套客户流失预警系统。
可运行的客户流失预警系统、高风险客户清单、模型评估结果和项目说明文档。
对数据科学、机器学习、商业分析和 Python 全栈表达感兴趣,希望把 AI 真正落进一个真实业务问题的学生。
它不是做一个脱离场景的算法练习,而是把“客户为什么会流失、商家能怎么提前行动”做成一个能解释、能展示、也能继续迭代的系统。
很多小型业态并不是不知道“老客户很重要”,而是不知道应该在什么时候、根据什么信号去判断一个客户正在慢慢流失。对咖啡馆这类复购驱动型生意来说,等客户真的不来了再去补救,通常已经太晚了。
这个项目的价值,就在于把原本依赖经验的判断过程变成一套可计算、可解释的系统。学生不会只停留在“训练一个模型”,而是要先理解客户行为、消费节奏、互动活跃度和价值贡献之间到底是什么关系,再决定怎样把这些因素组织成真正有判断力的特征。
| 对比维度 | 经验式经营 | 客脉守望者 |
|---|---|---|
| 判断客户风险 | 主要靠店主感觉和零散观察 | 结合消费、互动和价值贡献等多因子做系统判断 |
| 运营动作时机 | 客户明显流失后才补救 | 在流失风险上升前先识别并提前干预 |
| 输出结果 | 只有模糊印象,很难复盘 | 高风险客户名单 + 特征解释 + 运营建议 |
这门课不会把机器学习拆成零散知识点去讲,而是围绕同一个商业问题连续推进。学生每天都要同时回答两个问题:模型有没有更准,系统有没有更能用。
先看懂精品咖啡馆等小型业态为什么会有客户流失问题,再整理客户数据来源,完成缺失值、异常值和格式统一等清洗工作。
阶段成果 · 明确建模目标 + 干净的基础数据集
在基础消费指标之外继续补充行为活跃度、消费偏好和互动维度,把“客户像不像要流失”做成一组真正可用的核心特征。
阶段成果 · 完成核心特征集与相关性分析
训练随机森林模型,使用准确率、召回率、F1 和 AUC 等指标评估表现,并重点看模型对高风险客户的识别能力。
阶段成果 · 得到第一版模型与评估结果
通过参数调优和交叉验证控制过拟合,结合特征重要性解释模型为什么会这样判断,并把预测能力整理成可复用接口。
阶段成果 · 最优模型 + 流失风险评分接口
把模型接入 Flask 后台和 ECharts 风险看板,完成客户风险分布、重点名单和运营建议展示,并整理项目说明文档。
阶段成果 · 客户流失预警系统 + 项目说明文档
从项目结构上看,客脉守望者是一条从业务问题到产品交付的完整链路,而不是只停留在模型分数上。
先把“客户流失”变成一个清楚的业务判断问题,理解商家为什么需要在客户真正离开前做识别。
把客户行为拆成一组真正有判别力的指标,而不是只把原始数据直接扔进模型。
用随机森林完成分类预测,并结合特征重要性解释“模型为什么这样判断”。
把预测结果放进 Flask + ECharts 后台,让非技术用户也能直接看到风险分布、重点客户和对应建议。
不是只交一份代码,而是一个能上传数据、触发预测、查看结果的客户流失预警后台。
家长能看到模型准确率、AUC、特征重要性等关键结果,知道这个系统不是“随便猜”的。
系统能输出高风险客户名单,并配合关键特征分析,帮助理解后续运营动作为什么这样设计。
它本质上是一个数据科学项目,但不会把重点放在抽象公式推导上。学生既要理解模型逻辑,也要真的把数据处理、模型训练和 Web 展示系统做出来。
因为这个项目的核心不只是“预测对不对”,还包括“能不能解释给商家听”。随机森林在这类中小规模结构化数据问题里通常足够强,同时也更容易做特征重要性分析和业务解读。
不会。项目明确包含 Flask 后台、数据上传、模型调用和 ECharts 看板,所以最终交付会是一个能演示的系统,而不是只有静态报告。
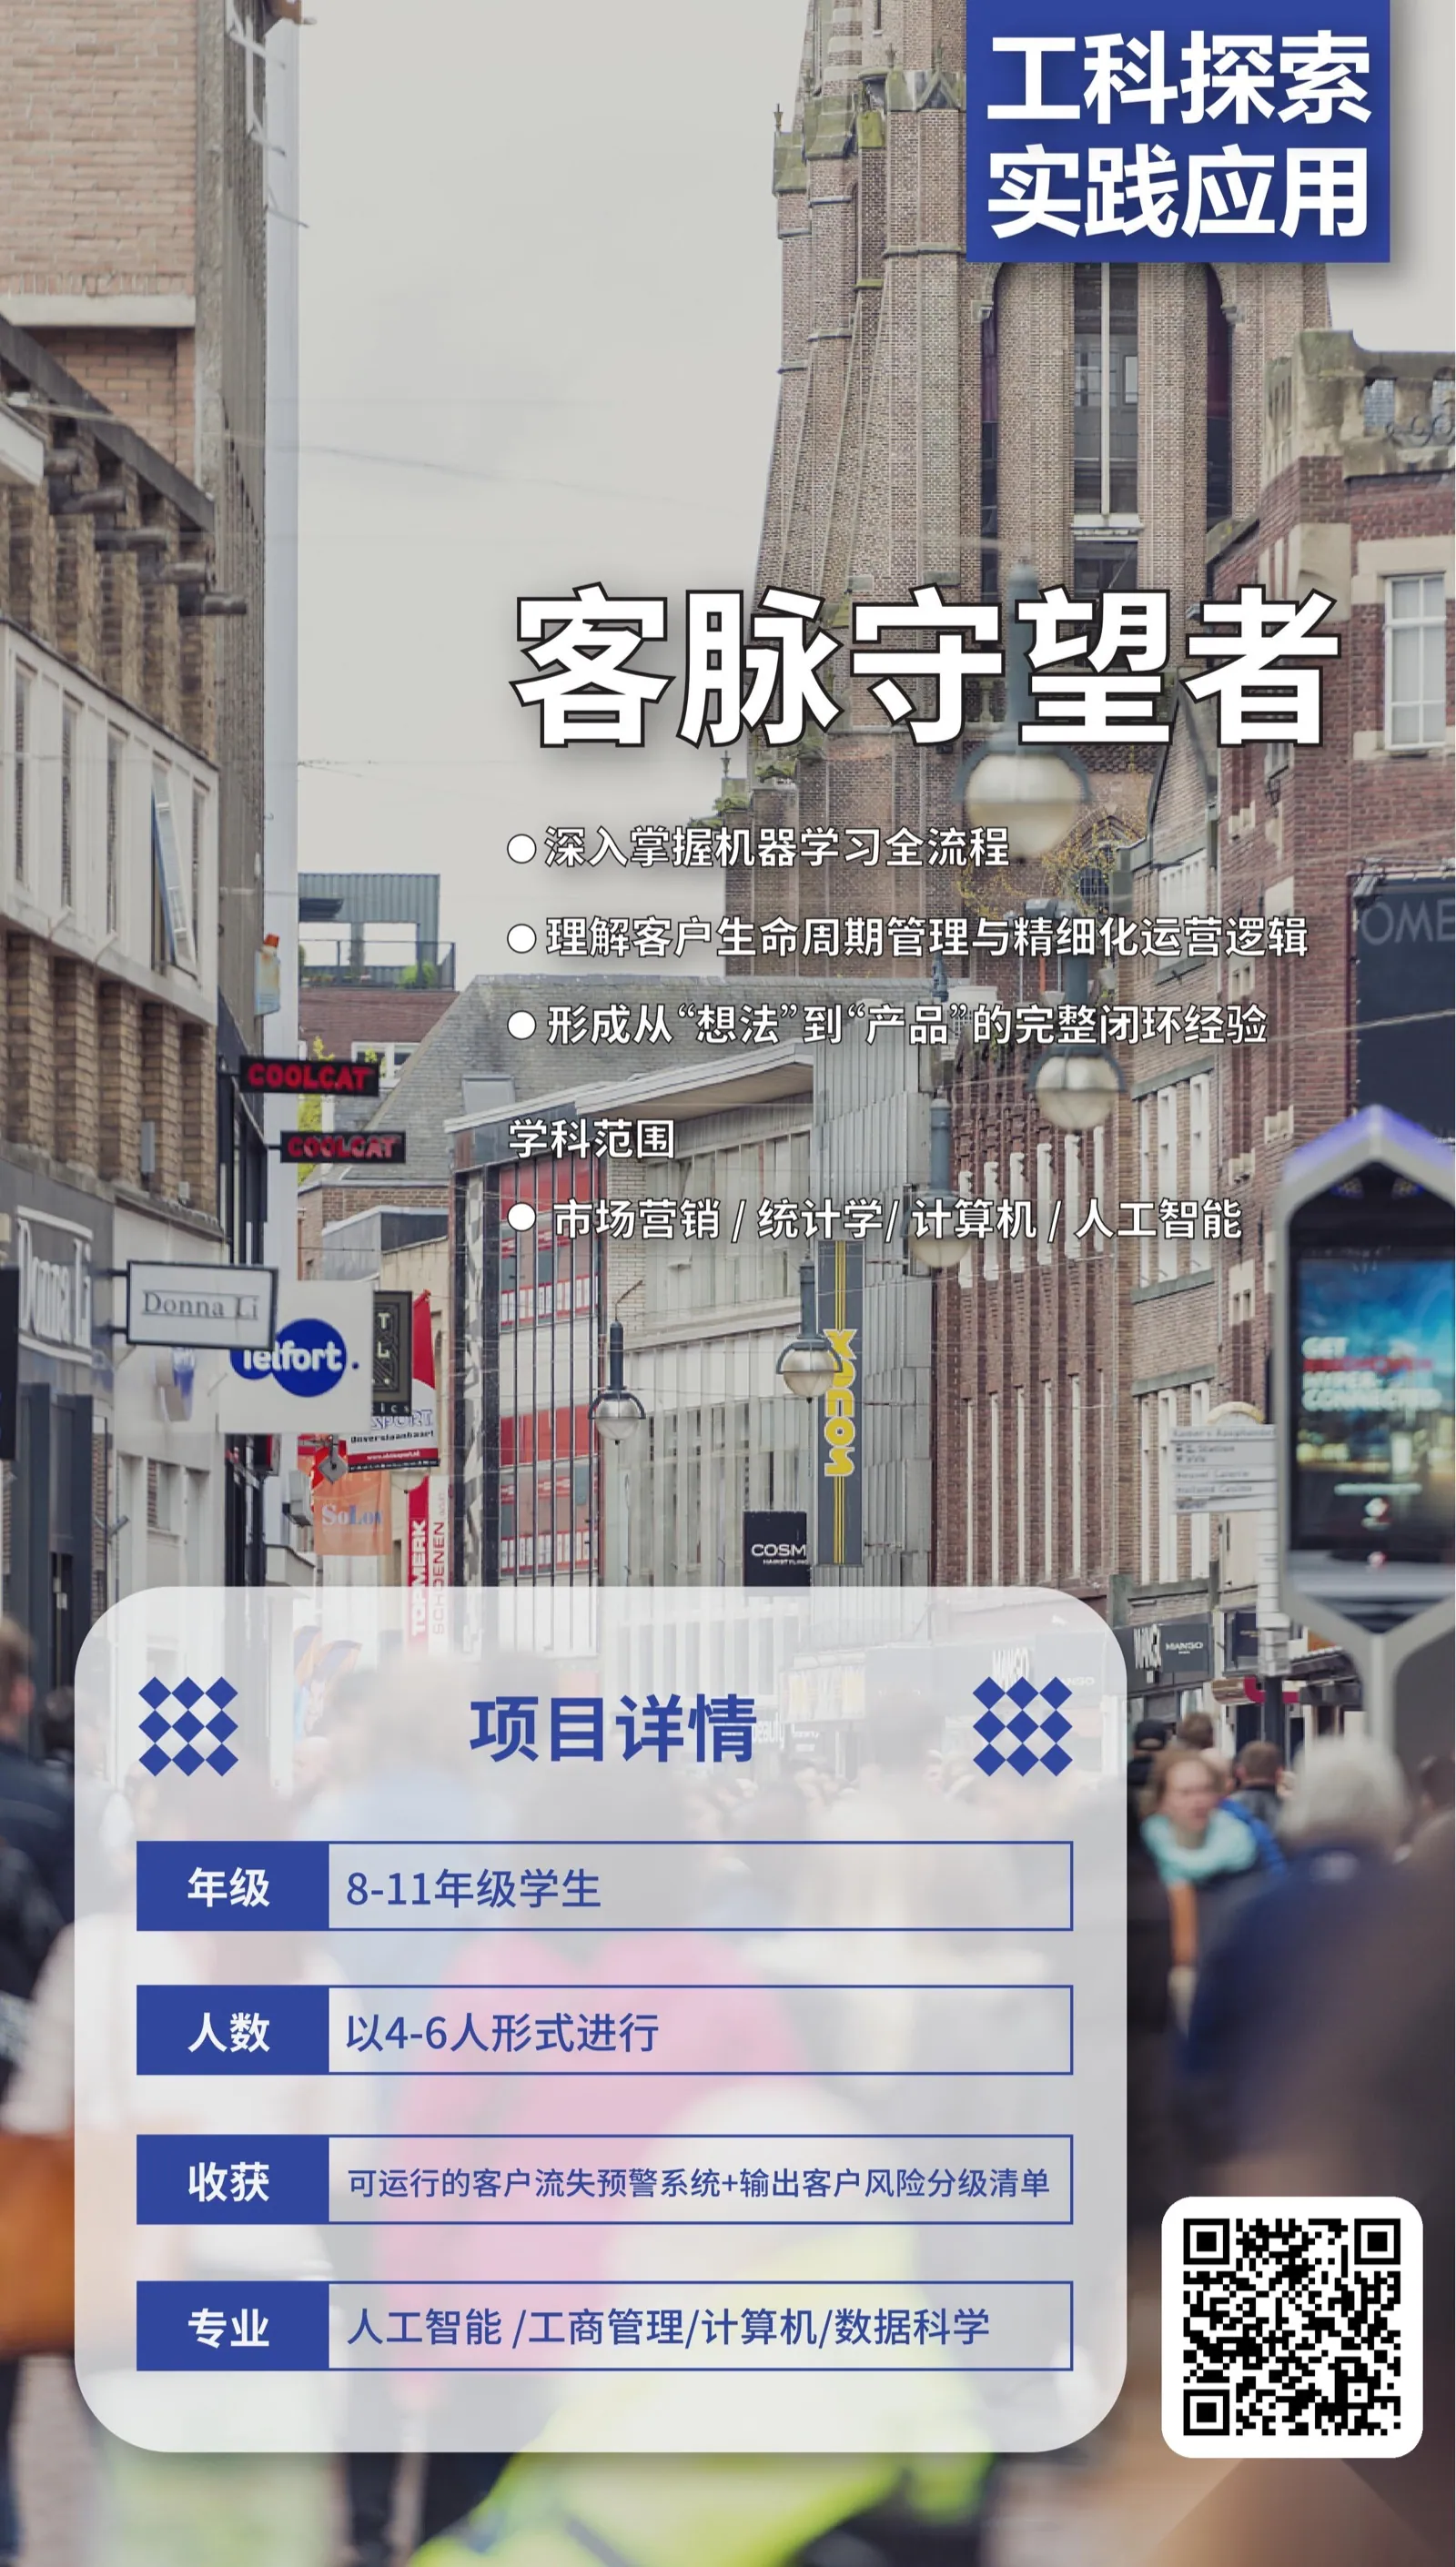
COURSE PLAN · PDF
包含课程目标、项目安排及成果说明。PDF · 252 KB · 文件归档于 2026-09-19
计划书中的班期与名额请联系老师确认。
LET’S BUILD SOMETHING
课程安排、学习基础和项目方向,欢迎与老师进一步沟通。
开班时间及名额以老师确认为准。